إن أردت أن تعرف هل يهلوس تطبيقك المبني على نموذج لغوي، فشغّله على أسئلة حقيقية اتفق مراجعوك مسبقًا على إجاباتها الصحيحة ومصادرها، وقِس الاسترجاع والإجابة كلًّا على حدة، ثم اقرأ النتائج موزّعة حسب اللغة ونوع السؤال ودور المستخدم. فالمتوسط الواحد قد يخفي إخفاقات تصيب فئة بعينها من المستخدمين.
فيما يلي المنهج: ماذا تقيس، وكيف تبني مجموعة الاختبار وتصنّفها، وأي المقاييس تستخدم وكيف تقرؤها. أما تحويل النتائج إلى قرارات إطلاق ومراقبة وتراجع، فتجده في دليلنا المكمّل عن بوابات الإطلاق والاستجابة للحوادث في أنظمة الذكاء الاصطناعي.
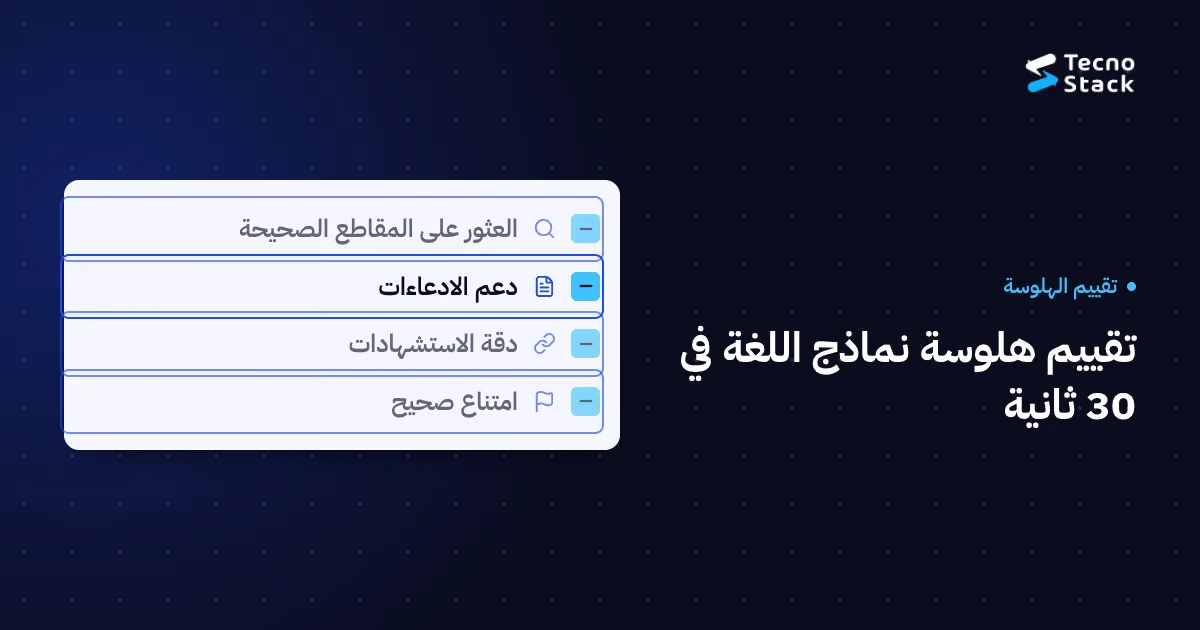
كلمة «الهلوسة» تجمع إخفاقات مختلفة، ولكل منها تصنيف مستقل. ويتناول ملحق NIST للذكاء الاصطناعي التوليدي هذا الخطر تحت اسم confabulation، أي محتوى خاطئ يُقدَّم بثقة. وفي تطبيق يجيب من مستنداتك، قسّمه أكثر:
- ادعاء غير مدعوم: تذكر الإجابة ما لا تقوله مصادرها، حتى لو كان صحيحًا مصادفة.
- إجابة خاطئة: تخالف الإجابةُ الإجابةَ المرجعية أو المصدر.
- استشهاد في غير موضعه: قد يكون الادعاء صحيحًا، لكن الاستشهاد يشير إلى مقطع لا يدعمه.
- إجابة بدل الامتناع عن الإجابة: لا يغطي السؤالَ أيُّ مصدر يحق للمستخدم الوصول إليه، ومع ذلك يجيب النظام.
«صحيح» و«مدعوم» شيئان مختلفان. فقد يقدّم النموذج معلومة صحيحة من بيانات تدريبه لا تتضمنها مستنداتك المعتمدة، وفي مساعد للسياسات الداخلية يبقى ذلك إخفاقًا، لأن فريقك لا يستطيع تتبّعها ولا تحديثها حين تتغير السياسة. اكتب هذه التعريفات قبل أن يصنّف أحدٌ أيَّ إجابة.
ابنِ مجموعة الاختبار مما سيسأله الناس حقًا؛ فالأسئلة التي يستمتع بها فريق التطوير بديل ضعيف. خذها من سجلات البحث وتذاكر الدعم والرسائل الواردة إلى الفريق المالك للمستندات، ومن مقابلات قصيرة مع المستخدمين المرتقبين، واحذف البيانات الشخصية قبل إدخال أي حالة.
ثم أضف عمدًا الحالات التي يقلّ ظهورها في الاستخدام المعتاد:
- أسئلة لا يجيب عنها أي مستند متاح، والسلوك الصحيح فيها الامتناع عن الإجابة؛
- أسئلة إجابتها في جدول أو ملف PDF ممسوح ضوئيًا أو موزّعة على مستندين؛
- السؤال نفسه من مستخدمين بأدوار مختلفة، لاختبار المحتوى المقيّد؛
- اختلافات الإملاء والاختصارات، وأسئلة تمزج العربية بالإنجليزية.
اكتب الأسئلة بكل لغة كما يكتبها أهلها بدل ترجمة مجموعة واحدة؛ فالأسئلة المترجمة لا تشبه ما يكتبه الناس في الواقع. ويضيف دليلنا عن RAG للشركات حالة تستحق مكانها في المجموعة: سؤال عربي إجابته في مستند إنجليزي.
ولا حجم يناسب الجميع. المهم أن تكفي الحالات في كل شريحة تهمك لملاحظة فرق قد يغيّر قرارك، فابدأ بمجموعة متواضعة مصنّفة بعناية ووسّعها مع كل إخفاق تكتشفه. أعطِ المجموعة رقم إصدار، وسجّل إصدار المستند الذي أخذت منه كل إجابة مرجعية، واحتفظ بجزء محجوز لا يضبط أحد التعليمات عليه.

شكل 1: استخدم أسئلة حقيقية. وأضف حالات بلا إجابة متاحة.
قد يختلف مراجعان دقيقان في قبول إجابة واحدة، ودليل التصنيف هو ما يجعل هذه الأحكام قابلة للتكرار. سجّل لكل حالة الإجابة المرجعية وصيغها المقبولة، والمقاطع التي يجب أن تعتمد عليها الإجابة الصحيحة، وهل ينبغي للنظام أن يمتنع عن الإجابة، وأي صياغة تكون ضارة حتى لو كانت دقيقة.
عرّف كل تصنيف بمثال، واحسم الحالات المحرجة مقدّمًا: هل تُعدّ الإجابة الجزئية صحيحة، وهل يُسقط غيابُ الاستشهاد إجابةً صحيحة، وماذا تفعل بإجابة صحيحة لكنها أطول من أن تُستخدم. اطلب من مراجعَين تصنيف العينة نفسها كلٌّ على حدة ثم قارن، وابحث في سبب كل خلاف: قد يكون الغموض في الدليل أو في المصدر أو في المعرفة التخصصية المطلوبة. احسم الحالة مع خبير المجال، ووضّح القاعدة، وأعد التصنيف عند الحاجة. وليملك خبراء كل مجال تصنيفات مجالهم: مراجع مالي لسياسة المصروفات، ومستشار قانوني لبنود العقود.
حين يسترجع النظام مستندات، افحص الاسترجاع وتوليد الإجابة؛ فقد ينشأ الإخفاق في أي منهما أو في مادة المصدر نفسها. لذلك قِس كل مرحلة وحدها:
- الاسترجاع: هل ظهرت المقاطع المطلوبة في النتائج التي وصلت إلى النموذج فعلًا، لا في الفهرس فقط؟
- دعم الإجابة: قسّم الإجابة إلى ادعاءات، وتحقق من كل ادعاء مقابل المقاطع المستشهد بها.
- دقة الاستشهاد: هل يشير كل استشهاد إلى مقطع يدعم الجملة المرتبطة به؟
- الصحة: هل توافق الإجابةُ الإجابةَ المرجعية؟
- الامتناع عن الإجابة: هل امتنع النظام عن الإجابة حين وجب ذلك، وأجاب حين أمكنه؟
إذا فات الاسترجاعَ المقطعُ المطلوب، فلن تأتي أي تعليمات توليد بالدليل الغائب. راجع صياغة استعلام البحث والتقسيم والبيانات الوصفية ومرشحات الصلاحيات وإعدادات البحث. وإذا وجده ثم انحرفت الإجابة، فراجع التعليمات أو ترتيب السياق أو النموذج نفسه. وأبقِ الفحوص الآلية البسيطة حيثما أمكن: وجود معرّفات المقاطع المستشهد بها، ومطابقة صيغة المخرجات، وتطابق القيم المنقولة ووحداتها مع المصدر.
حدّد مقام كل نسبة. يمكن حساب تغطية الاسترجاع بقسمة عدد المقاطع المطلوبة التي أُعيدت على جميع المقاطع المطلوبة للحالات القابلة للإجابة. ونسبة دعم الادعاءات هي عدد الادعاءات الواقعية المدعومة مقسومًا على جميع الادعاءات الواقعية المفحوصة. واعرض أيضًا نسبة الإجابات المدعومة بالكامل؛ فقد ترتفع النسبة على مستوى الادعاء مع بقاء إجابات كثيرة مدعومة جزئيًا فقط. افصل الحالات غير القابلة للإجابة، ووثّق طريقة حساب المتوسط عبر الأسئلة.

شكل 2: قِس كل مرحلة منفصلة. حدّد موضع الإصلاح.
تقييم آلاف الإجابات يدويًا بطيء، لذلك تعطي فرق كثيرة معايير مكتوبة لنموذج ثانٍ وتتركه يقيّم. قد ينجح ذلك، لكن المقيِّم نموذج آخر له أخطاؤه، وعليك قياسها. شغّله أولًا على حالات صنّفها مراجعوك، وقارن أحكامه تصنيفًا تصنيفًا ولغةً لغة، واقرأ الحالات التي يخالفهم فيها؛ فالمقيِّم الذي يتفق مع مراجعيك في الإجابات الإنجليزية قد لا يتفق معهم في العربية.
وثّق إصدار تعليمات المقيِّم ونموذجه كأي مكوّن آخر، وأعد مقارنته بالعينة البشرية كلما تغيّر أحدهما قبل مقارنة الدرجات الجديدة بالقديمة. وإلا فلن تعرف هل تغيّر النظام أم تغيّرت المسطرة.
اعرض كل مقياس لكل شريحة مع عدد الحالات بجانب كل نسبة. ومن الشرائح المفيدة: اللغة (العربية والإنجليزية والمختلطة)، ونوع السؤال (استعلام مباشر ومقارنة وأسئلة متعددة الخطوات وأسئلة رقمية)، وصيغة المستند، ودور المستخدم، وحداثة تغيّر المصدر. فقد يبدو النظام مقبولًا إجمالًا ثم يخفق في الأسئلة الرقمية بالعربية، وقد تكون هذه تحديدًا الشريحة التي يعتمد عليها فريقك المالي.
والشرائح الصغيرة كثيرة التذبذب، فإذا رأيت فرقًا في حالات قليلة فأضف حالات قبل أن تستنتج شيئًا. وعند مقارنة النماذج، ثبّت مجموعة الاختبار والمقيِّم وغيّر عاملًا واحدًا في كل مرة؛ وهو الانضباط نفسه الذي نطبقه في مقارنتنا لعائلات النماذج الداعمة للعربية.
يصف NIST إطاره لإدارة مخاطر الذكاء الاصطناعي بأنه إرشادات طوعية، فهو ليس شهادة ولا قانونًا، وينظّم العمل على المخاطر في أربع وظائف: Govern وMap وMeasure وManage. والمنهج أعلاه ينتمي في معظمه إلى وظيفة Measure، لكنه يعتمد على Map، إذ لا يمكنك اختيار تصنيفات الإخفاق والشرائح قبل فهم سياق النظام ومستخدميه وأضراره المحتملة. وقد نشر NIST في 26 يوليو 2024 ملحق الذكاء الاصطناعي التوليدي (NIST AI 600-1) امتدادًا للإطار. كلا المرجعين يساعد على تنظيم العمل، ولا يضمن أيٌّ منهما أن النظام آمن أو خالٍ من المحتوى الخاطئ.
التوصيات في هذا المقال إرشادات عملية من تكنوستاك، لا متطلبات من NIST. وإن كنت تخطط لمساعد أو أداة بحث أو وكيل، فيمكن لفريق خدمة أنظمة الذكاء الاصطناعي أن يساعدك في تحديد التصنيفات والمقاييس والشرائح قبل الإطلاق.
- المعهد الوطني للمعايير والتقنية الأمريكي (NIST). AI Risk Management Framework: إرشادات طوعية منظمة حول وظائف Govern وMap وMeasure وManage.
- المعهد الوطني للمعايير والتقنية الأمريكي (NIST). Generative Artificial Intelligence Profile (NIST AI 600-1)، نُشر في 26 يوليو 2024 ملحقًا لإطار AI RMF.


